글을 한 줄도 못 쓰는 AI 모델이 나왔습니다. ChatGPT 뒤의 연구에 있던 사람이 2년을 들여 만든 Jev인데, 대신 소프트웨어가 반복해서 내려야 하는 판단을 0.1초 안에 돌려줍니다. 같은 질문을 던진 공개 데모에서 0.114초와 8.566초가 찍혔고, 답을 내는 값은 아예 받지 않습니다. 채팅 자리가 아니라 코드 안의 조건문 자리를 노린 물건입니다. 발표문에 적힌 숫자와 회사가 스스로 밝힌 한계, 그리고 직접 깔아 보며 확인한 것과 막힌 지점까지 정리했습니다.
판단 하나에 8초, 기다리시겠어요
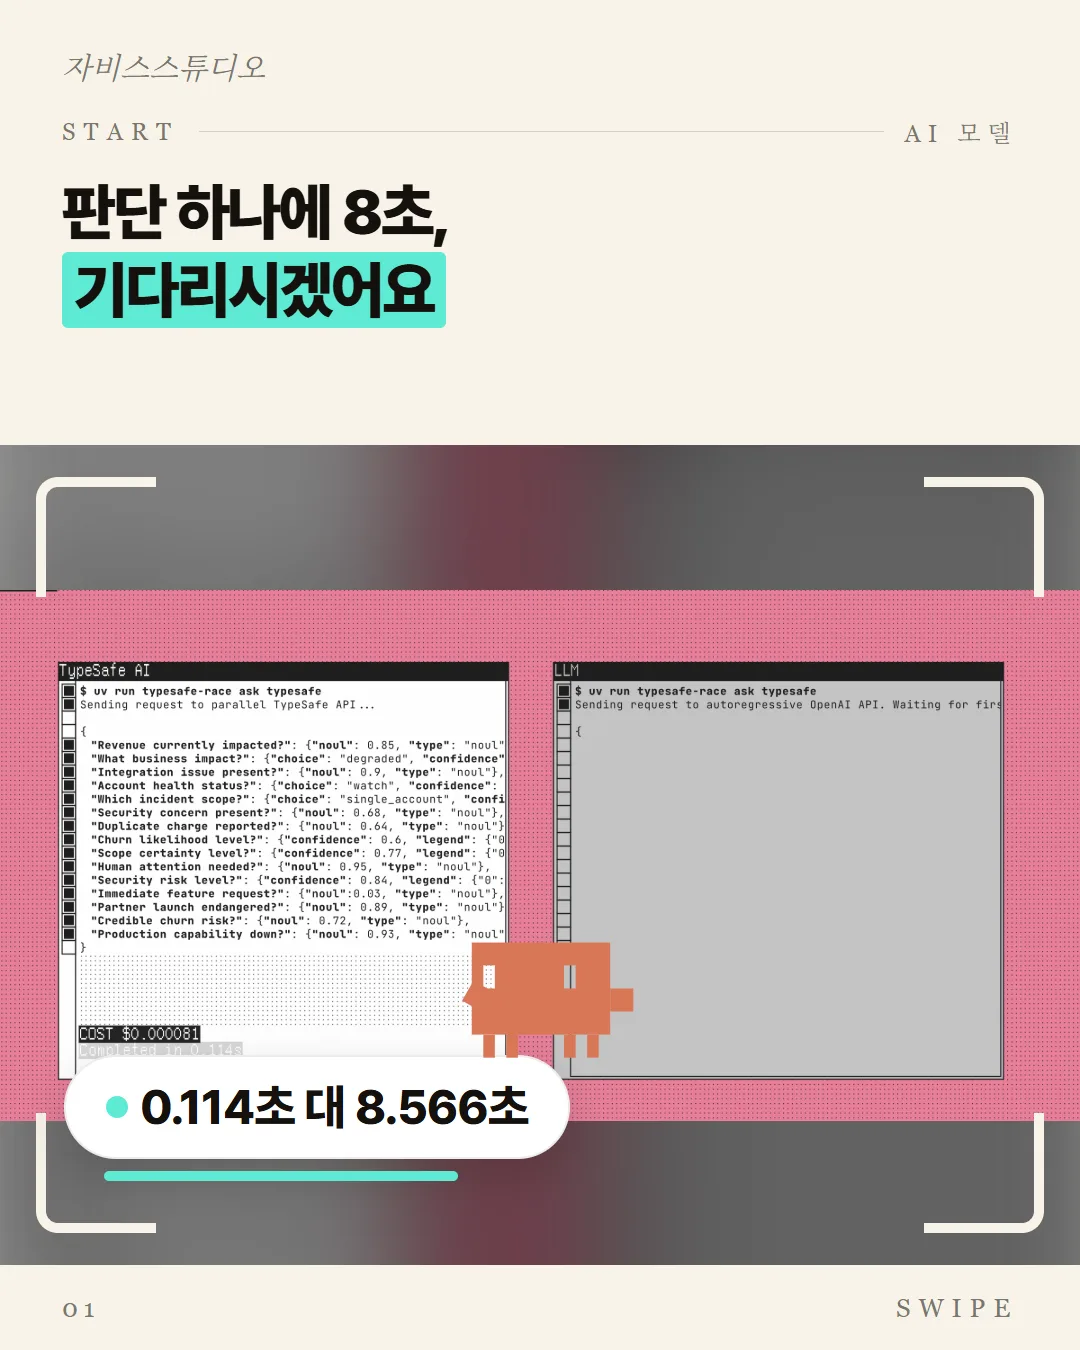
TypeSafe가 공개한 화면은 단순합니다. 같은 고객 상황을 두 모델에 던지고 열다섯 개 남짓한 질문을 한꺼번에 물었습니다. 매출에 영향이 있는지, 사람이 봐야 하는지, 보안 문제인지 같은 것들입니다. 왼쪽 창은 답을 다 뱉고 끝났는데 오른쪽은 아직 첫 글자를 기다리고 있습니다. 화면 아래에 걸린 시간이 그대로 찍혀 있습니다. 0.114초와 8.566초, 그리고 한 번 부르는 데 든 돈이 각각 0.000081달러와 0.013880달러입니다. 던진 질문도 참인지 묻는 것과 여럿 중 고르는 것이 섞여 있습니다.
이런 소식, 남들보다 먼저 받으실 분?
직접 돌려보고 되는 것만 골라 매주 보내드립니다. 광고성 하이프는 거릅니다.
매일 하는 이 판단들, 사람 손이 갑니다
이 판단들은 특별한 게 아닙니다. 메일 하나 열어서 급한 건지 보고, 문의가 들어오면 어디로 넘길지 정하고, 리뷰를 훑어 문제 있는 것만 골라내는 일입니다. 지금은 사람이 하나씩 보거나, 규칙을 잔뜩 적어 둔 코드가 어설프게 처리합니다. 한 줄짜리 조건문으로는 잡히지 않는 애매한 판단들입니다. 문서는 질문을 잘게 쪼개라고 권합니다. "이 피치를 평가하라"가 아니라 시장 규모와 실현 가능성과 차별성을 따로 묻고, 가중치는 내 코드에서 정하라는 겁니다. 우선순위가 바뀌면 프롬프트를 다시 쓸 게 아니라 숫자 하나만 고치면 됩니다.
같은 걸 물었는데 여기서 갈립니다
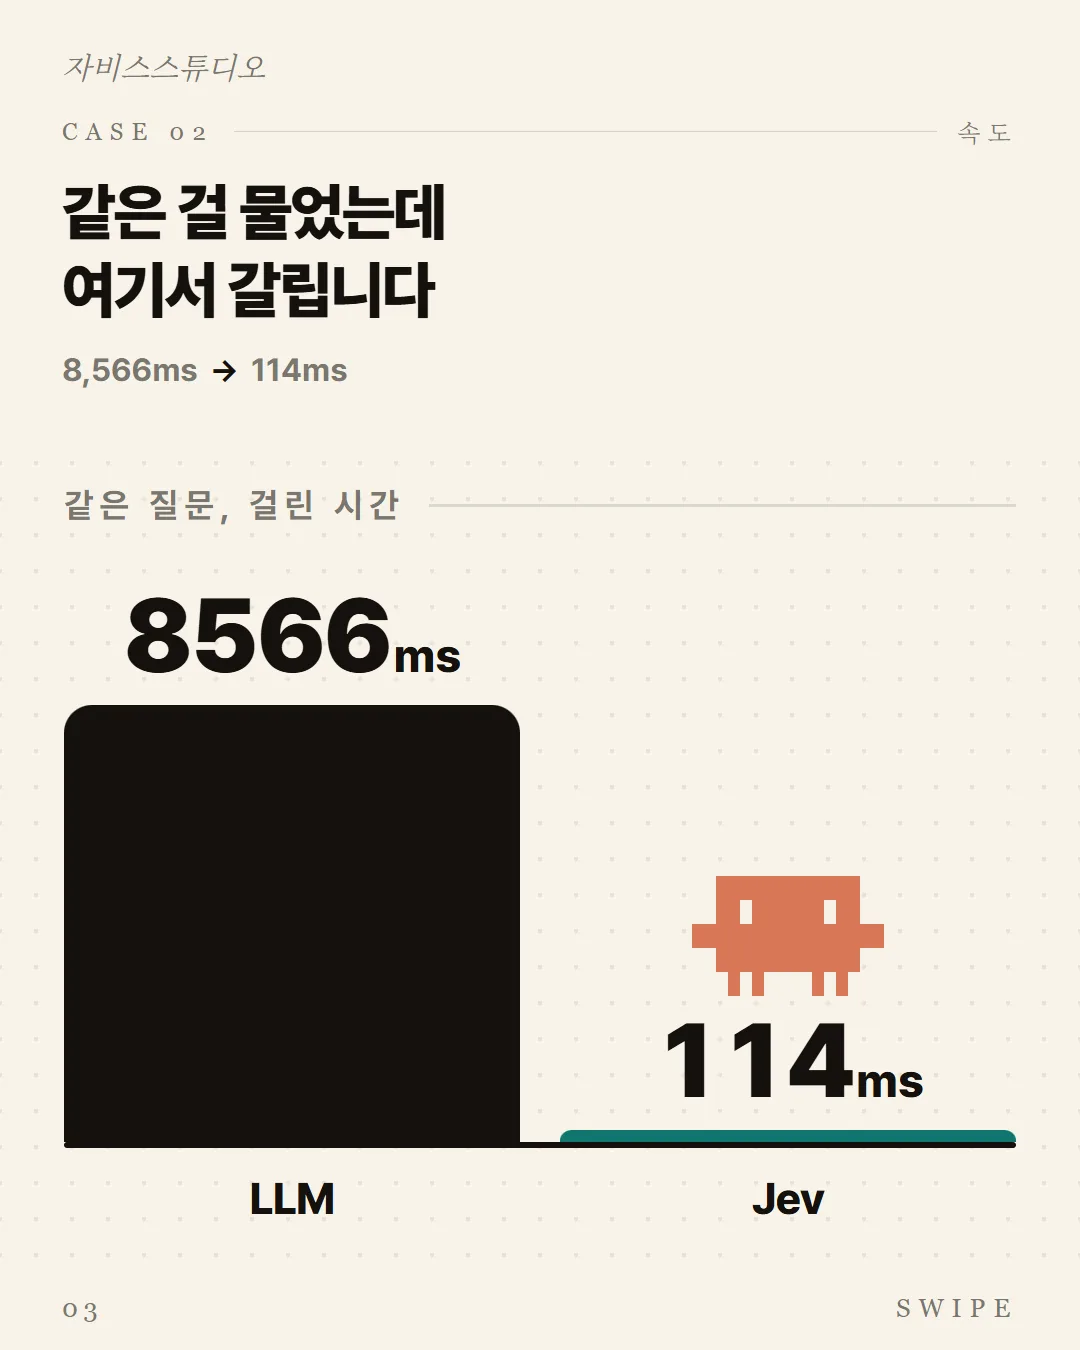
속도 차이는 구조에서 옵니다. 일반적인 언어 모델은 토큰을 하나씩 이어 붙이고 그때마다 앞 결과에 기댑니다. Jev는 질문 전체를 한 번에, 서로 독립적으로 평가합니다. 그래서 질문을 더 넣어도 응답 시간이 거의 늘지 않고, 앞 질문이 뒤 질문을 오염시키지도 않습니다. 공개된 응답 시간은 70밀리초에서 500밀리초 사이입니다. 비교 대상인 프런티어 모델은 3초에서 329초가 걸린다고 적혀 있고, 같은 수준의 판단에서 40배에서 200배 빠르다는 것이 회사의 주장입니다.
답값은 안 받습니다, 읽은 만큼만 냅니다
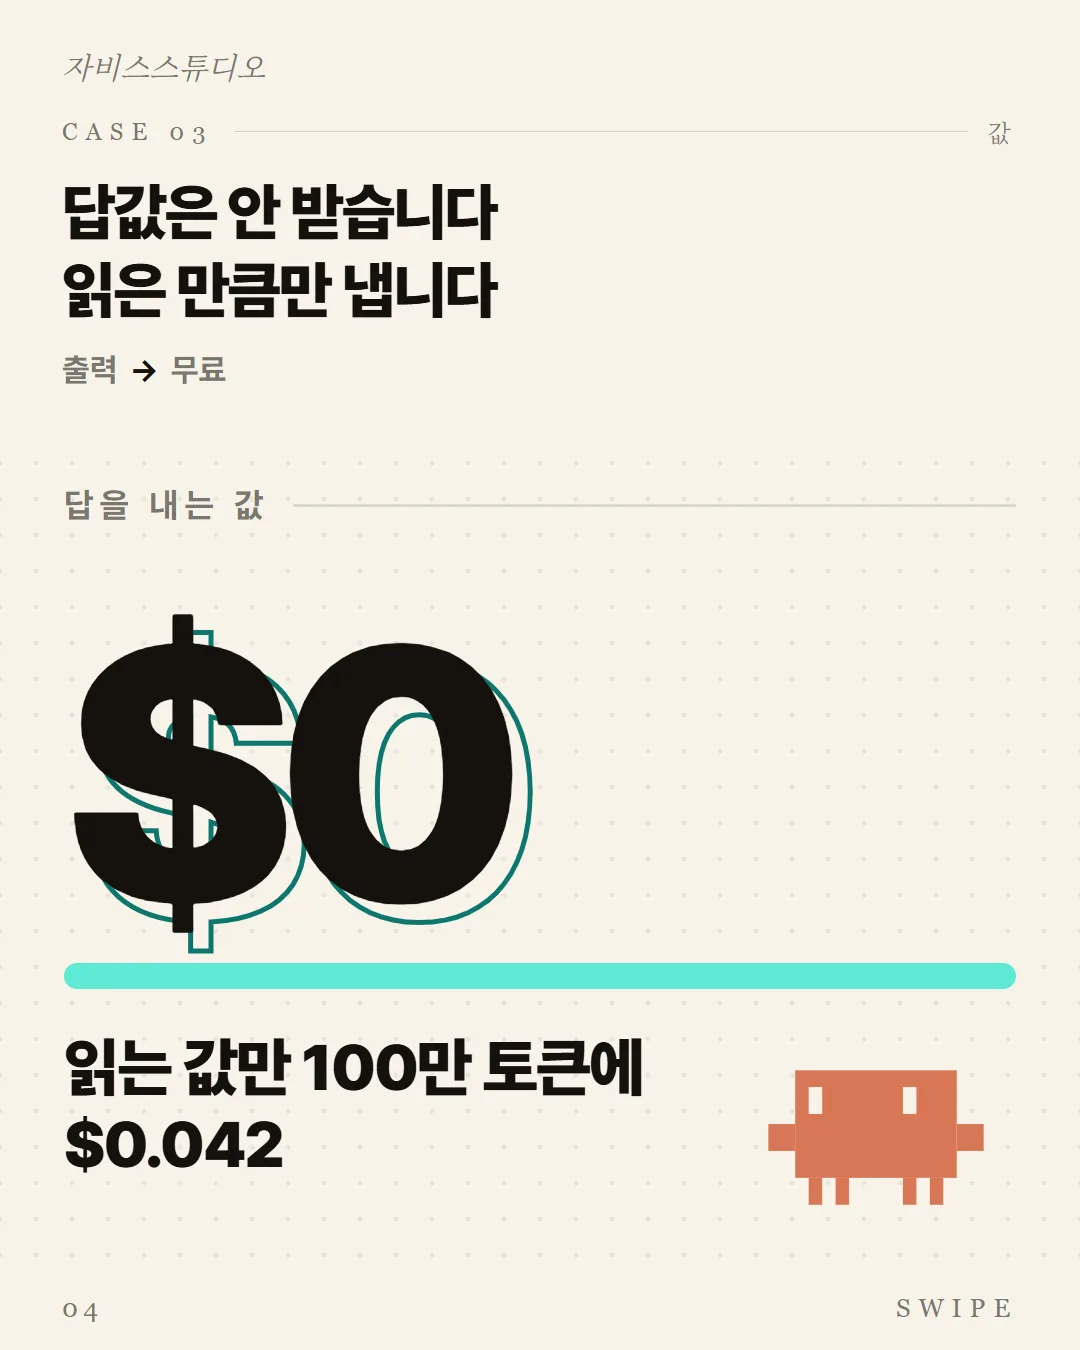
가격표가 특이합니다. 입력은 100만 토큰에 0.042달러이고 출력은 아예 값을 매기지 않습니다. 재는 게 무의미할 만큼 싸다는 설명입니다. 비교표에 적힌 일반 언어 모델의 입력값은 100만 토큰에 0.20달러에서 10달러 사이이고, 출력은 대개 입력의 다섯 배쯤 받습니다. 판단을 많이 돌릴수록 격차가 벌어지는 구조입니다. 출력이 공짜라는 건 답을 아무리 많이 받아도 그쪽으로는 값이 늘지 않는다는 뜻이기도 합니다. 참고로 이 회사가 보여준 게임 봇 데모는 초당 열 번씩 질의를 날리는데, 그래도 시간당 7달러 정도라고 적어 뒀습니다.
쓸 줄 몰라서 더 빠릅니다
Jev는 문장을 만들지 못합니다. 대신 가능한 답과 구조를 미리 정해 두기 때문에 형식이 틀어지는 일이 구조적으로 없습니다. 흥미로운 건 이 대목에서 회사가 스스로 선을 긋는다는 점입니다. 다른 수치는 실제로 재서 얻었지만 타입 오류 0퍼센트만은 측정값이 아니라 수학적으로 보장되는 값이라고 따로 밝혀 뒀습니다. 파싱하고 검증하고 예외를 잡던 코드가 통째로 필요 없어진다는 뜻이기도 합니다. 다만 미리 정해 둔다는 건 고를 수 있는 답의 가짓수도 정해진다는 말입니다. 한 번에 고를 수 있는 선택지는 255개까지이고, 그보다 많으면 점수를 먼저 매긴 뒤 고르는 두 단계로 돕니다.
볼 것만 골라서 넘겨줍니다
실무에서 더 중요한 건 속도보다 이쪽일 수 있습니다. 모든 답에 확률과 신뢰도가 함께 나옵니다. 자신 있으면 높은 값이, 애매하면 낮은 값이 붙고 그 값이 실제 정확도와 맞물리도록 훈련했다는 것이 회사 설명입니다. 그래서 임계값을 정해 두면 확신이 높은 건 그냥 지나가고 낮은 것만 사람에게 옵니다. 비교표에는 기존 모델의 문제를 이렇게 적어 뒀습니다. 95퍼센트를 맞히더라도 나머지 5퍼센트가 언제인지 말해주지 못하면 자동화할 수 없다는 겁니다. 훈련 방식의 이름도 여기서 나왔습니다. 사람 취향이나 채점 가능한 정답이 아니라 정직한 확률을 목표로 삼았다고 합니다.
자기 약점까지 적어 뒀습니다
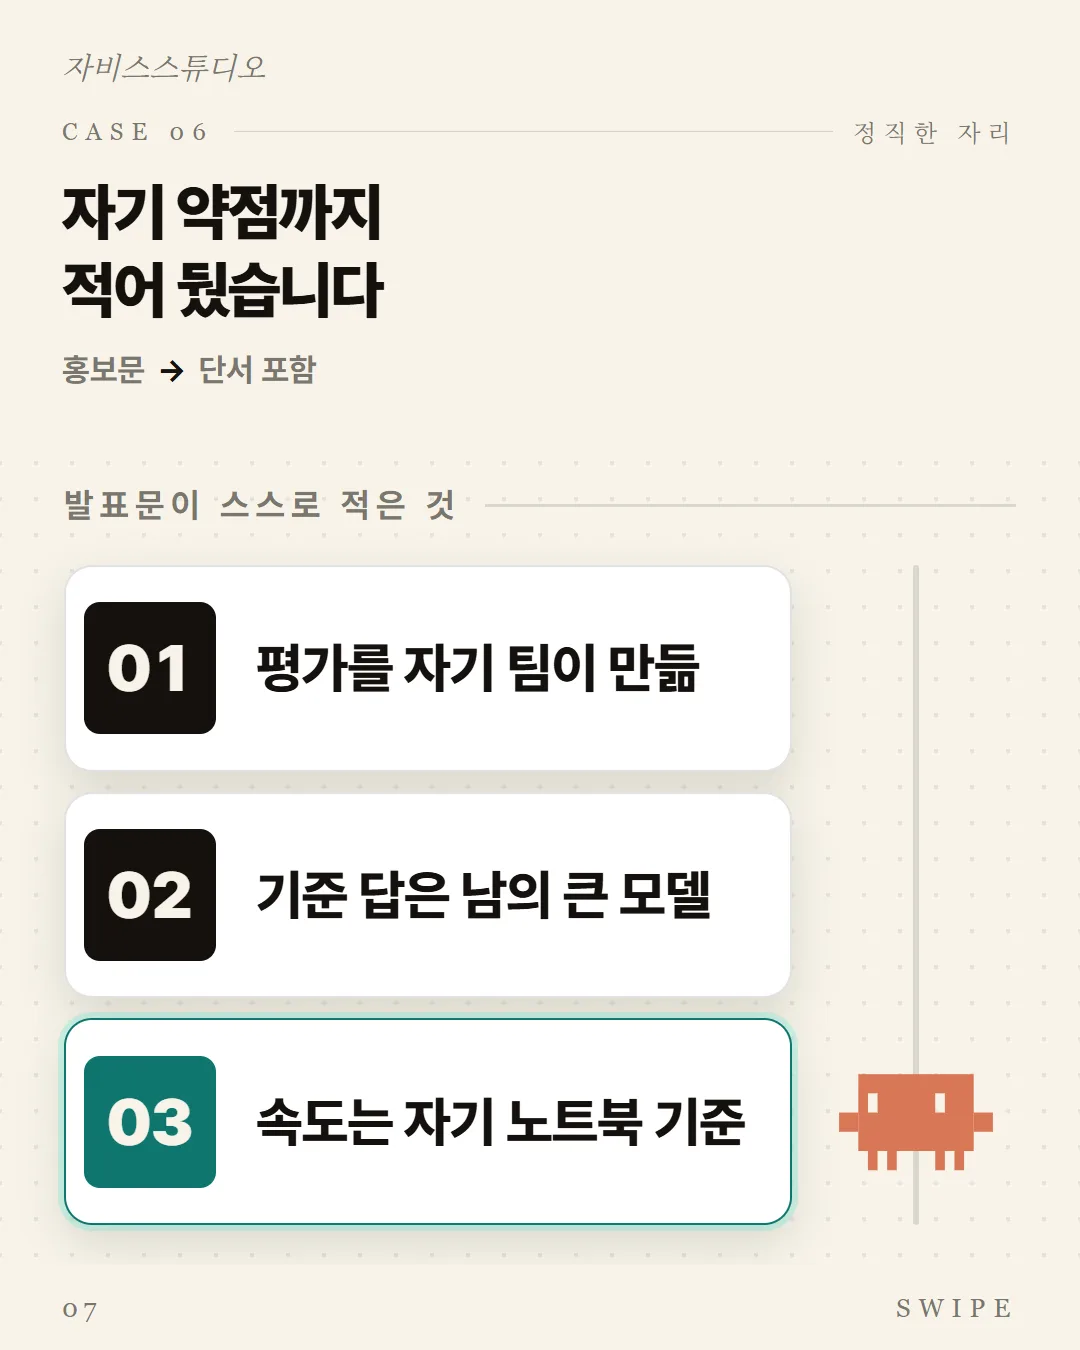
이 발표문에서 가장 눈에 띈 건 숫자가 아니라 태도였습니다. 주장마다 「Nuance」라는 칸을 두고 불리한 조건을 직접 적어 뒀습니다. 평가에 쓴 워크플로를 자기 팀이 만들었으니 편향이 있을 수 있다는 것, 기준 답을 다른 회사의 큰 모델 둘의 평균으로 삼아 그쪽에 유리하게 기울 수 있다는 것, 속도 측정이 서비스와 가까운 자기 노트북에서 돌았다는 것까지 밝혔습니다. 홍보 글에서 보기 드문 자리라 오히려 나머지 수치가 믿을 만해집니다. 평가에 쓴 워크플로 넷을 모두 공개했고, 그중 가장 단순한 것은 글 안에 그대로 실었습니다.
정리: 지금 해볼 수 있는 것
직접 깔아 봤습니다. 문서는 본 사이트가 아니라 별도 주소에 있고, 사이트의 문서 경로는 404가 뜨는데 그 404 페이지가 SDK 위치를 알려줍니다. SDK 자체는 승인 없이도 받아집니다. 설치는 패키지 하나에 11초가 걸렸고 버전은 0.6.0, 라이선스는 MIT입니다. 다만 MIT인 건 클라이언트 SDK이고 모델은 별개의 서비스입니다. 질문을 정의하는 데까지는 키 없이도 됩니다. 실제로 짜 보니 프롬프트 문자열이 아니라 타입 정의에 가까운 JSON이 나왔습니다. 막히는 곳은 클라이언트를 만드는 순간이고, 키가 없다는 오류가 바로 납니다. 지금은 대기 줄에 서야 하고, 승인이 나면 실제 호출 결과를 따로 정리하겠습니다.